Metas nya villkor: får Meta läsa din hemsida?
Skriven av
Sörmlands Webbyrå
Publicerad
19 oktober 2026
Lästid
5 min
En frisör i Flen har Instagram-företagskonto. En elektriker i Nyköping har Facebook-sida. Båda såg rubriker om att Meta skulle få crawla deras hemsidor och träna AI på dem.
Metas nya villkor för företag träder i kraft 30 oktober 2026. Efter kritik den 17 oktober strök Meta ordet train ur crawl-stycket och knöt det till annons- och företagsprodukter. Vi har läst rapporteringen, Metas crawler-dokumentation och förhandsvisningen av villkoren.
Det här är inte juridisk rådgivning. Osäker? Läs villkoren själv.
Vad händer 30 oktober?
Nya kommersiella villkor gäller den som använder Meta i företaget. Ett stycke ger Meta rätt att crawla sajter kopplade till verksamheten. Den 17 oktober skrevs syftet om: annons- och företagsprodukter — inte att “träna” Meta-produkter i allmänhet.
Nuvarande Commercial Terms (6 mars 2024) har inget crawl-stycke. Förhandsvisningen som ska gälla 30 oktober har ett: Meta får använda scrapers, botar och crawlers mot sajter kopplade till dina produkter eller tjänster, och får skapa “test credentials”.
Så såg den första versionen ut. Nieman Lab, Search Engine Journal och PPC Land citerade den 15–16 oktober. Jurister läste det som en öppning att scrapa nyhetssajter och träna AI.
Den 17 oktober skrevs stycket om. I förhandsvisningen vi öppnade 19 oktober slutar det med advertising and business products, plus integritet och säkerhet. Ordet train är borta där. Daniel Roberts sa till The Verge och TechCrunch att crawlingen de samlade bara gällde ads- och business-produkter, att det inte ändrar hur Meta använder webcrawlers, och att sajtägare fortfarande kan signalera i robots.txt.
Rätten att crawla finns kvar. Den breda träningsformuleringen togs bort.
Gäller det om jag bara har en Facebook-sida?
Ja — villkoren räknar bland annat Page och Meta Business Suite som affärsändamål, inte bara den som köper annonser.
Fortsätter du använda produkterna efter 30 oktober, säger villkoren att du godtar dem. Det finns inget kryssrute-opt-out.
För den som redan kör Facebook-annonser är mycket av det här inte nytt. Self-Serve Ad Terms ger redan Meta rätt att crawla annonsörens sajt, inklusive research and training, när du lägger en order.
Har du bara en sida för jobb-bilder i Strängnäs eller Katrineholm är det alltså avtalet — inte en ny bot — som är nyheten.
Får Meta träna AI på min hemsida?
Crawl-stycket som gäller 30 oktober nämner inte träning. Separat från villkoren har Meta redan en crawler som enligt deras dokumentation hämtar sidor för att träna grundmodeller — den styrs i robots.txt.
Blanda inte ihop två saker. Villkoren, efter 17 oktober, knyter syftet till annons- och företagsprodukter — det såg vi i Metas egen förhandsvisning. Samtidigt står det i Metas crawler-dokumentation att Meta-ExternalAgent crawlar för training foundation AI models or improving products by indexing content directly. Den boten fanns före den här uppdateringen.
En vanlig företagshemsida är redan offentlig. Villkoren ändrar avtalet mot Meta, inte vad som syns på sajten.
Hur AI och personuppgifter hänger ihop i ert eget arbete tar vi i GDPR och AI.
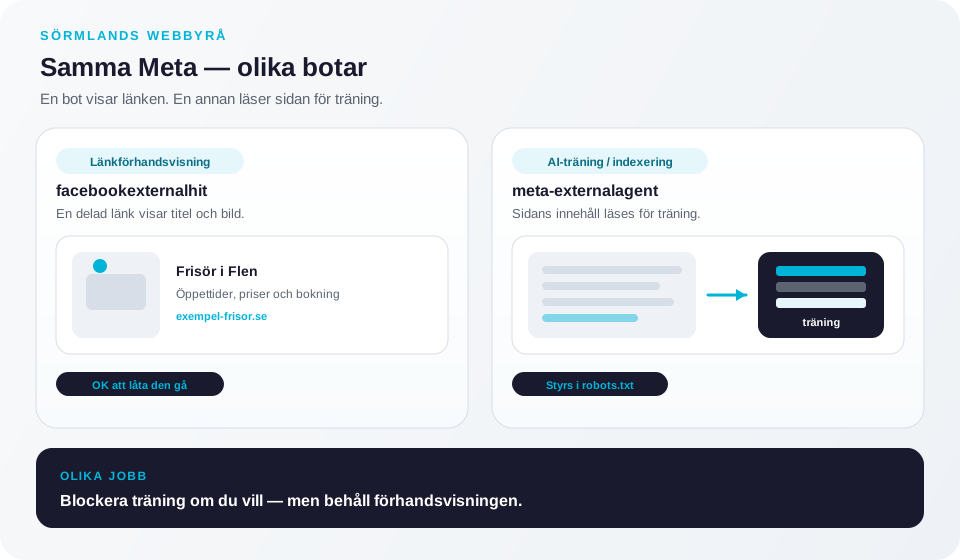
facebookexternalhit visar länken. meta-externalagent läser sidan. Det är inte samma sak.
Hur ser jag om Metas botar besöker sajten?
Titta i access-loggarna efter user-agent; Metas dokumentation listar namnen.
Hos de flesta webbhotell finns loggarna i kontrollpanelen, eller via Cloudflare. En träff betyder att boten hämtat en sida — inte att innehållet hamnat i en viss modell.
| Bot (user-agent) | Vad Meta skriver att den gör |
|---|---|
facebookexternalhit | Titel, beskrivning och bild när någon delar länken i Facebook, Instagram eller Messenger |
meta-externalagent | Träna grundmodeller eller indexera innehåll direkt |
meta-webindexer | Förbättra Meta AI-sök; tillåten crawl hjälper Meta att citera och länka |
meta-externalads | Förbättra annonsering och andra företagsprodukter |
meta-externalfetcher | Hämtar enskilda länkar på användarens begäran; får gå förbi robots.txt |
Ändringar i robots.txt kan enligt Meta ta upp till 24 timmar. Samma slags logg-tänk som i teknisk SEO: först se vad som händer, sen styra.
Hur styr jag dem i robots.txt?
Blockera meta-externalagent om du inte vill att träningscrawlern ska hämta sajten, men låt facebookexternalhit vara — annars kan förhandsvisningen i Facebook och Instagram bli tom.
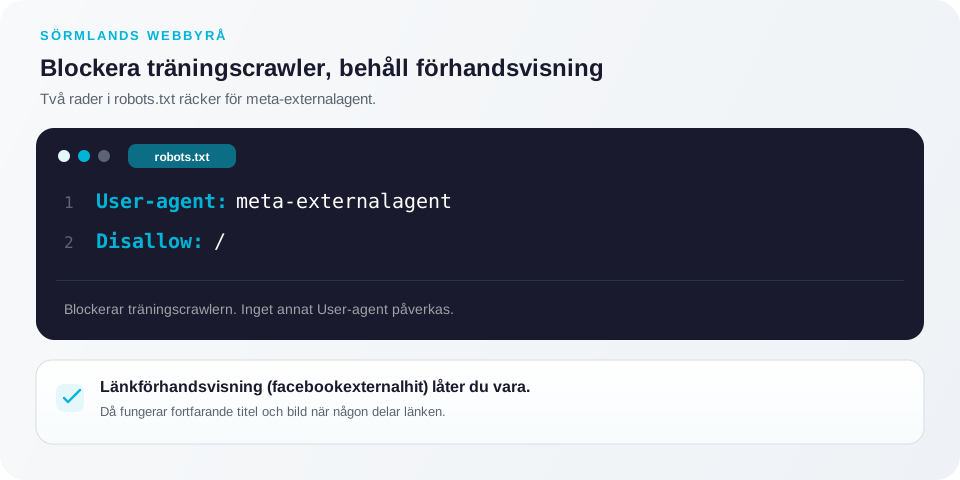
User-agent: meta-externalagent
Disallow: /
Gör inte User-agent: * med Disallow: /. Då stänger du Google också.
Tre saker från Metas dokumentation: Meta-ExternalFetcher may bypass robots.txt (hämtning på användarens begäran). facebookexternalhit might bypass den vid säkerhetskontroller, inte som huvudregel för vanliga förhandsvisningar. Villkoren nämner inte robots.txt — Meta säger i uttalanden att sajtägare fortfarande kan signalera preferenser där.
Vill du synas när någon frågar en AI vem de ska anlita i Sörmland är avvägningen en annan: se AEO. Där är poängen ofta att inte stänga crawlers av reflex.
Vad bör en hantverkare, frisör eller städfirma göra?
Ingen panik. Läs villkoren om du är osäker, stäng inte Facebook-sidan för den här nyheten. Träningscrawlern kan du styra i robots.txt utan att släcka länkförhandsvisningen.
- Använd sidan som vanligt om den fungerar för kunder.
- Kolla loggarna en gång, så du ser vilka Meta-botar som redan varit där.
- Bestäm medvetet: ska
meta-externalagentfå läsa, eller inte? - Rör inte
facebookexternalhitom ni delar länkar till sajten i flödet.
Samma Facebook-sida ni publicerar från lyder under villkoren. Hur ni tar fram inläggen tar vi i AI i sociala medier.
Villkoren kan ändras igen. Det här är vad som stod i förhandsvisningen 19 oktober 2026.
Vill du att vi tittar på er robots.txt? Hör av er.
Källor
- Meta Commercial Terms — förhandsvisning, ikraft 30 oktober 2026
- Nuvarande Meta Commercial Terms (6 mars 2024)
- Meta Self-Serve Ad Terms
- Meta Web Crawlers
- Nieman Lab, 15 oktober 2026
- Search Engine Journal, 16 oktober 2026
- PPC Land, 16 oktober 2026
- TechCrunch, 17 oktober 2026
- The Verge, 17 oktober 2026
Vanliga frågor
Gäller Metas nya villkor för företag om jag bara har en Facebook-sida?
Får Meta träna AI på min hemsida efter 30 oktober?
Måste jag blockera Metas crawler?
Försvinner länkförhandsvisningen om jag blockerar Meta i robots.txt?
Relaterat för dig
Nästa steg
Om du vill omsätta tipsen i praktiken kan du börja här: