Vad är robots.txt? Filen som styr vad Google får titta på
Skriven av
Sörmlands Webbyrå
Publicerad
9 november 2026
Lästid
3 min
En robots.txt är en liten textfil som talar om för sökrobotar vilka delar av sajten de får gå in på. En sökrobot, även kallad crawler, är det automatiska program som sökmotorer använder för att läsa av webben. Många företagare söker på vad robots txt är när de bygger om hemsidan i WordPress eller Astro. Här ser du när filen behövs och hur du slipper ett vanligt misstag vid lansering.
När behöver din hemsida en egen fil?
De flesta vanliga företagshemsidor behöver sällan ändra något i filen alls. I Googles introduktion till robots.txt på Search Central framgår att filen främst ska hindra sökrobotar från att överbelasta servern med onödiga besök.
Har du en vanlig sajt i WordPress skapar systemet eller ditt SEO-tillägg oftast en vettig grundfil automatiskt. Bygger webbyrån en snabb sajt i Astro lägger utvecklaren in en färdig textfil som pekar ut sidkartan, alltså listan över sajtens viktiga sidor.
Filen styr vilka mappar roboten ska hoppa över, till exempel inloggningssidor, kundkorgar eller interna sökresultat. Då lägger Google sin tid på dina riktiga tjänstesidor i stället, vilket är en grundbult i teknisk SEO. Samtidigt minskar den onödiga trafiken på webbhotellet, skriver MDN Web Docs i sin ordlista om robots.txt. Det avlastar din huvudserver på ungefär samma sätt som ett CDN.
Viktigt att veta är att filen inte fungerar som ett kassaskåp för hemliga dokument. Om en annan webbsida länkar till en avstängd adress kan Google ändå visa själva länken i sökresultatet. Sidor som inte alls får synas på Google ska därför låsas med lösenord. De kan också märkas med noindex, alltså en kodrad som förbjuder sökmotorn att spara sidan.
Så tittar du på din egen robots.txt
Du ser din egen fil genom att skriva /robots.txt direkt efter ditt domännamn i webbläsarens adressfält. Har ditt företag adressen exempel.se skriver du alltså exempel.se/robots.txt och trycker på enter.
På skärmen dyker det upp några korta rader med enkel text utan bilder eller design. De två vanligaste raderna ser ut så här när hela sajten är öppen för besök:
User-agent: *
Disallow:
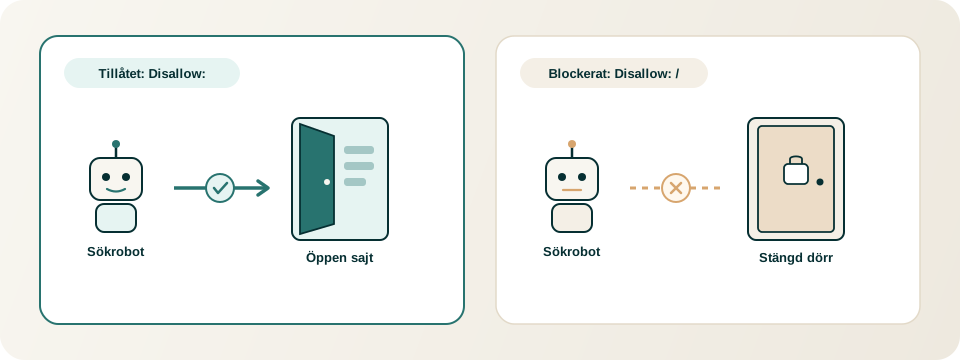
Raden User-agent: * betyder att regeln gäller alla besökande sökrobotar. När det är helt tomt efter Disallow: är dörren öppen, och sökmotorerna får läsa hela hemsidan.
Misstaget som stänger ute Google efter lansering
Ett enda litet snedstreck efter ordet Disallow: räcker för att stänga ute Google från hela din hemsida. Under en ombyggnad i WordPress eller i en testmiljö för Astro kryssar utvecklaren ofta i en ruta som ber sökmotorer att hålla sig borta.
Då skriver systemet in ett snedstreck i filen, alltså Disallow: /, vilket betyder att alla mappar från startsidan och nedåt är förbjudna. Om ingen tar bort den spärren på lanseringsdagen slutar Google att läsa in dina sidor.
Du märker oftast misstaget genom att sajten tappar sina placeringar eller inte dyker upp alls när kunder söker. Om du har kopplat sajten till Google Search Console varnar verktyget tydligt när viktiga sidor stoppas av filen. Be då din webbyrå eller din SEO-tekniker att öppna inställningarna och ta bort spärren, så sköter de de tekniska detaljerna.
Som Cloudflare beskriver i sin genomgång av hur robots.txt fungerar är filen en artig överenskommelse snarare än en brandvägg. Seriösa sökmotorer som Google följer reglerna direkt, medan skräpbotar kan strunta i dem. På senare tid har filen även fått en ny uppgift. Allt fler företag lägger nu in regler för de AI-robotar som samlar in text till chattjänster.
Källor
- Introduction to robots.txt (Google Search Central)
- Robots.txt – MDN Web Docs Glossary (Mozilla)
- What is robots.txt? | How a robots.txt file works (Cloudflare Learning)
Vanliga frågor
Vad är robots.txt på en hemsida?
Hur ser jag min egen robots.txt?
Räcker robots.txt för att dölja en privat sida på Google?
Relaterat för er
Nästa steg
Om ni vill omsätta tipsen i praktiken kan ni börja här:
- Hemsida till småföretag
- SEO och lokal synlighet
- WordPress-underhåll och support
- Tillgänglighetsanpassning (WCAG & DOS-lagen)
- Skapa logga för företaget – praktisk guide
- Vad är DNS? Telefonkatalogen som pekar din adress rätt
- Tillgänglighetsguiden – starta här
- Vår strategi-tjänst
- Kundcase i Sörmland
- Kontakt